Gradient Boost Part 1 (of 4): Regression Main Ideas
3-Second Blueprint (English)
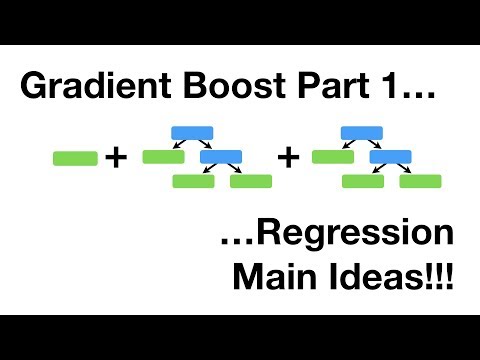
- Gradient Boost regression starts with a single leaf predicting the average target value across all training samples.
- Sequential fixed-size trees (often 8–32 leaves) fit the pseudo-residuals—the errors between observed and predicted values.
- Scaling each tree by a small learning rate (like 0.1) takes gradual steps that lower variance on unseen test data.
Gradient Boost regressionPseudo-residualsFixed-leaf decision treesLearning rate scalingBias-variance trade-off
3-Sekunden-Fazit (Deutsch)
- Gradient-Boost-Regression beginnt mit einem einzelnen Blatt, das den Durchschnittswert aller Trainingsdaten vorhersagt.
- Folgebäume fester Größe (oft 8–32 Blätter) modellieren die Pseudo-Residuen zwischen Beobachtung und aktueller Vorhersage.
- Eine kleine Lernrate (etwa 0,1) skaliert jeden Baum in kleinen Schritten und senkt so die Varianz auf Testdaten.
Gradient-Boost-RegressionPseudo-ResiduenBäume mit fester BlattzahlLernraten-SkalierungBias-Varianz-Abwägung
Note / Hinweis: Blueprints are AI-generated educational summaries (0% Politics · 0% Religion · 0% Brainrot) and do not constitute medical, legal, or financial advice. / KI-generierte Zusammenfassung zu Bildungszwecken – ersetzt keine medizinische, rechtliche oder finanzielle Fachberatung.