Transformers Attend Over Tokens. Why Not Over Layers?
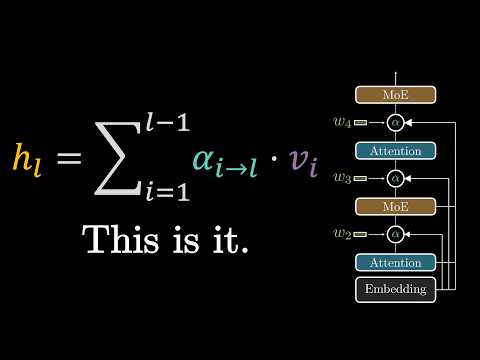
3-Second Blueprint (English)
- Attention Residuals replace fixed skip sums with depth-wise softmax attention over prior layers, curbing activation norm growth and loss.
- Zero-initializing query vectors starts training as a uniform layer average, while block attention cuts activation memory overhead.
- Micro-batching and interleaved virtual pipeline stages across GPUs shrink pipeline bubbles to train deep attention-residual models.
Attention ResidualsResidual ConnectionsPipeline ParallelismTransformer Architecture
3-Sekunden-Fazit (Deutsch)
- Attention Residuals ersetzen feste Skip-Summen durch Softmax-Attention über frühere Schichten und dämpfen Aktivierungswachstum und Loss.
- Null-initialisierte Query-Vektoren starten das Training als gleichmäßiges Mittel; Block-Attention senkt den Aktivierungsspeicherbedarf.
- Micro-Batching und verschachtelte virtuelle Pipeline-Stufen reduzieren GPU-Leerlaufzeiten (Pipeline Bubbles) beim Großmodell-Training.
Attention ResidualsResidual-VerbindungenPipeline-ParallelismusTransformer-Architektur
Note / Hinweis: Blueprints are AI-generated educational summaries (0% Politics · 0% Religion · 0% Brainrot) and do not constitute medical, legal, or financial advice. / KI-generierte Zusammenfassung zu Bildungszwecken – ersetzt keine medizinische, rechtliche oder finanzielle Fachberatung.