Attention for Neural Networks, Clearly Explained!!!
3-Second Blueprint (English)
- Basic LSTM encoder-decoder models struggle on long texts because unrolling compresses the entire input into one fixed context vector.
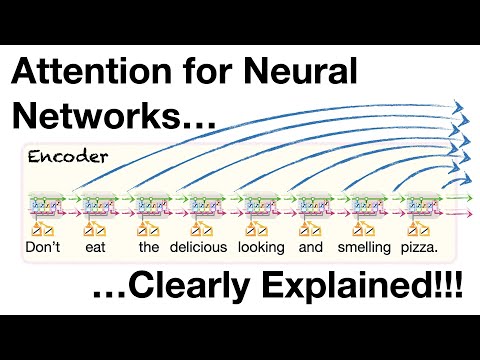
- Attention connects all encoder hidden states to each decoding step, using dot-product similarity and softmax to weight relevant inputs.
- Dynamic attention context vectors dramatically improve long-range translation and remove the need for recurrent LSTMs in Transformers.
Encoder-Decoder AttentionDot-Product SimilaritySoftmax Alignment WeightsDynamic Context Vector
3-Sekunden-Fazit (Deutsch)
- Einfache LSTM-Encoder-Decoder scheitern bei langen Texten, da der gesamte Eingabesatz in einen einzigen festen Kontextvektor gepresst wird.
- Attention verbindet alle Encoder-Zustände direkt mit jedem Decoder-Schritt und gewichtet Relevanz per Skalarprodukt sowie Softmax-Funktion.
- Dynamische Kontextvektoren verbessern lange Übersetzungen massiv und machen rekurrente LSTMs in modernen Transformern völlig überflüssig.
Encoder-Decoder-AttentionSkalarprodukt-ÄhnlichkeitSoftmax-GewichtungDynamischer Kontextvektor
Note / Hinweis: Blueprints are AI-generated educational summaries (0% Politics · 0% Religion · 0% Brainrot) and do not constitute medical, legal, or financial advice. / KI-generierte Zusammenfassung zu Bildungszwecken – ersetzt keine medizinische, rechtliche oder finanzielle Fachberatung.