Running Llama on Tenstorrent AI Accelerator vs NVIDIA GPU
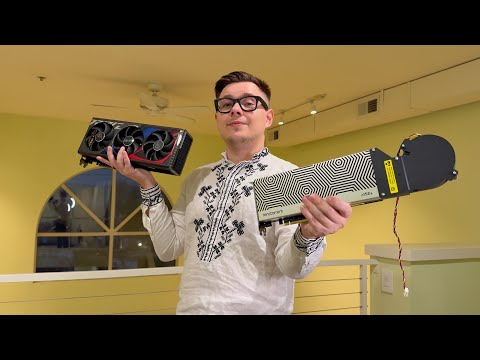
3-Second Blueprint (English)
- Running Llama 3.1 8B on Tenstorrent Wormhole requires building the TT-Metal SDK and Tenstorrent's dedicated vLLM fork.
- Both NVIDIA CUDA and Tenstorrent setups serve OpenAI-compatible HTTP endpoints for side-by-side latency benchmarking.
- While NVIDIA GPUs deliver higher raw throughput per card, Tenstorrent Wormhole achieves competitive performance per dollar.
Tenstorrent TT-MetalvLLMLlama 3.1 8BCUDA
3-Sekunden-Fazit (Deutsch)
- Llama 3.1 8B auf Tenstorrent Wormhole erfordert das Kompilieren des TT-Metal-SDKs sowie des angepassten vLLM-Forks.
- Sowohl NVIDIA-CUDA- als auch Tenstorrent-Server bieten OpenAI-kompatible Endpunkte für direkte Latenz-Benchmarks.
- NVIDIA-GPUs liefern mehr Rohleistung pro Karte, doch Tenstorrent-Beschleuniger erreichen eine konkurrenzfähige Leistung pro Dollar.
Tenstorrent TT-MetalvLLMLlama 3.1 8BCUDA
Note / Hinweis: Blueprints are AI-generated educational summaries (0% Politics · 0% Religion · 0% Brainrot) and do not constitute medical, legal, or financial advice. / KI-generierte Zusammenfassung zu Bildungszwecken – ersetzt keine medizinische, rechtliche oder finanzielle Fachberatung.