How do Multimodal AI models work? Simple explanation
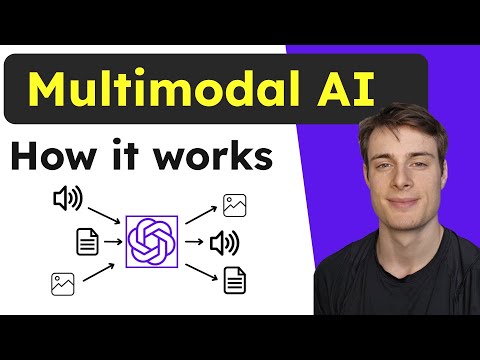
3-Second Blueprint (English)
- Multimodal AI maps distinct data types like text, images, and audio into a shared semantic embedding space of meaning vectors.
- Contrastive models like CLIP train text and image encoders jointly on captioned pairs to condition downstream diffusion generators.
- Multi-output interfaces orchestrate specialized models via language and can use RLHF human feedback to resolve output modality intent.
Semantic EmbeddingsCLIP Contrastive ModelDiffusion ConditioningRLHF Alignment
3-Sekunden-Fazit (Deutsch)
- Multimodale KI-Modelle überführen Text, Bilder und Audio über Embedding-Netze in einen gemeinsamen semantischen Bedeutungsraum.
- Kontrastive Modelle wie CLIP trainieren Text- und Bild-Encoder gemeinsam an Bild-Text-Paaren zur Steuerung von Diffusionsmodellen.
- Multimodale Systeme koppeln Spezialmodelle über Sprache und nutzen RLHF-Feedback, um die gewünschte Ausgabemodalität zu bestimmen.
Semantische EmbeddingsCLIP-ModellDiffusionssteuerungRLHF-Ausrichtung
Note / Hinweis: Blueprints are AI-generated educational summaries (0% Politics · 0% Religion · 0% Brainrot) and do not constitute medical, legal, or financial advice. / KI-generierte Zusammenfassung zu Bildungszwecken – ersetzt keine medizinische, rechtliche oder finanzielle Fachberatung.