What is Mutli-Head Attention in Transformer Neural Networks?
3-Second Blueprint (English)
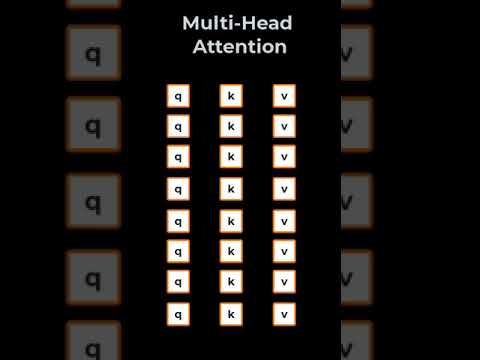
- Multi-head attention maps each input word vector into Query, Key, and Value vectors and splits each across eight parallel heads.
- Paired Query and Key subspaces compute eight distinct attention matrices that weight the corresponding Value vectors independently.
- Concatenating all eight head outputs produces a single unified word vector enriched with richer multi-aspect contextual meaning.
Multi-Head AttentionQuery-Key-Value (QKV)Attention MatricesTransformer Architecture
3-Sekunden-Fazit (Deutsch)
- Multi-Head Attention projiziert jeden Wortvektor auf Query-, Key- und Value-Vektoren und teilt diese auf acht parallele Köpfe auf.
- Aus den Query- und Key-Teilräumen entstehen acht separate Aufmerksamkeitsmatrizen, die jeweils die Value-Vektoren gewichten.
- Das Verketten aller acht Kopf-Ausgaben liefert einen einzigen Wortvektor, der vielfältige kontextuelle Beziehungen besser erfasst.
Multi-Head AttentionQuery-Key-Value (QKV)Attention-MatrizenTransformer-Architektur
Note / Hinweis: Blueprints are AI-generated educational summaries (0% Politics · 0% Religion · 0% Brainrot) and do not constitute medical, legal, or financial advice. / KI-generierte Zusammenfassung zu Bildungszwecken – ersetzt keine medizinische, rechtliche oder finanzielle Fachberatung.