Byte-Pair Encoding (BPE) Tokenizer #machinelearning #datascience #naturallanguageprocessing #nlp
3-Second Blueprint (English)
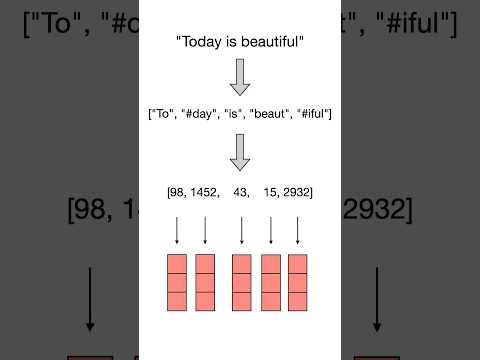
- Pre-tokenizes raw input sentences into individual words and initializes a base vocabulary from unique characters or byte values.
- Counts co-occurrence frequencies across all adjacent character pairs to identify the highest-frequency sequence in the corpus.
- Iteratively merges the most frequent token pairs into new subword entries until reaching the target LLM vocabulary size limit.
Byte-Pair Encoding (BPE)Subword TokenizationVocabulary ConstructionLLM Pre-processing
3-Sekunden-Fazit (Deutsch)
- Zerlegt Rohtext zunächst in einzelne Wörter und erstellt ein Basisvokabular aus allen vorkommenden Zeichen oder Byte-Werten.
- Zählt die Häufigkeit sämtlicher benachbarter Zeichenpaare im Textkorpus, um die am häufigsten auftretende Paarung zu ermitteln.
- Verschmilzt iterativ die häufigsten Token-Paare zu neuen Teilwörtern, bis die definierte Zielgröße des LLM-Vokabulars steht.
Byte-Pair Encoding (BPE)Subwort-TokenisierungVokabularaufbauLLM-Textverarbeitung
Note / Hinweis: Blueprints are AI-generated educational summaries (0% Politics · 0% Religion · 0% Brainrot) and do not constitute medical, legal, or financial advice. / KI-generierte Zusammenfassung zu Bildungszwecken – ersetzt keine medizinische, rechtliche oder finanzielle Fachberatung.