But how do AI images and videos actually work? | Guest video by Welch Labs
3-Second Blueprint (English)
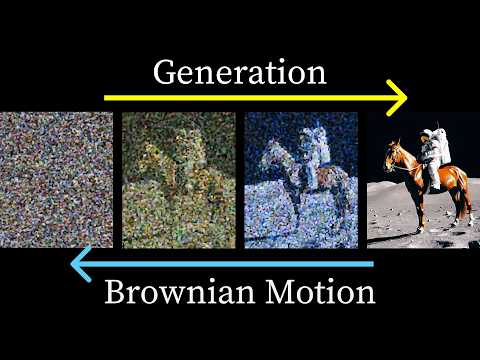
- Diffusion models treat images as points in high-dimensional pixel space and learn time-varying vector fields to reverse Gaussian noise.
- DDIM and flow matching convert stochastic Brownian denoising into deterministic trajectories that generate sharp media in far fewer steps.
- Shared text-image embeddings and classifier-free guidance steer denoising trajectories toward text prompts and away from negative prompts.
Diffusion Models & DDPMDDIM & Flow MatchingCLIP EmbeddingsClassifier-Free Guidance
3-Sekunden-Fazit (Deutsch)
- Diffusionsmodelle deuten Bilder als Punkte im hochdimensionalen Pixelraum und lernen Vektorfelder, um Gaußsches Rauschen umzukehren.
- DDIM und Flow Matching überführen stochastisches Entrauschen in deterministische Pfade für scharfe Bilder in deutlich weniger Schritten.
- Gemeinsame Text-Bild-Embeddings und Classifier-Free Guidance lenken die Trajektorien gezielt zum Prompt und weg von Negativ-Prompts.
DiffusionsmodelleDDIM & Flow MatchingCLIP-EmbeddingsClassifier-Free Guidance
Note / Hinweis: Blueprints are AI-generated educational summaries (0% Politics · 0% Religion · 0% Brainrot) and do not constitute medical, legal, or financial advice. / KI-generierte Zusammenfassung zu Bildungszwecken – ersetzt keine medizinische, rechtliche oder finanzielle Fachberatung.