Unicode, in friendly terms: ASCII, UTF-8, code points, character encodings, and more
3-Second Blueprint (English)
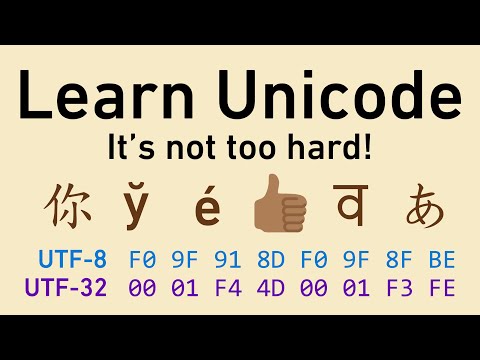
- ASCII maps 128 characters to 1 byte each, while Unicode maps human graphemes to one or more code points.
- UTF-32 uses a fixed 4 bytes per code point, whereas UTF-8 encodes each code point in 1 to 4 bytes.
- Decoding bytes with the wrong scheme causes mojibake, and accurate string ops require grapheme awareness.
ASCII & UnicodeCode Points vs GraphemesUTF-8 & UTF-32Mojibake PreventionGrapheme-Aware Strings
3-Sekunden-Fazit (Deutsch)
- ASCII nutzt 1 Byte für 128 Zeichen; Unicode ordnet sichtbare Grapheme einem oder mehreren Codepoints zu.
- UTF-32 belegt fest 4 Bytes pro Codepoint, während UTF-8 variabel 1 bis 4 Bytes pro Codepoint nutzt.
- Falsche Dekodierung erzeugt Zeichensalat (Mojibake); präzise String-Logik muss Grapheme beachten.
ASCII & UnicodeCodepoints vs. GraphemeUTF-8 & UTF-32Mojibake-VermeidungGraphem-Stringfunktionen
Note / Hinweis: Blueprints are AI-generated educational summaries (0% Politics · 0% Religion · 0% Brainrot) and do not constitute medical, legal, or financial advice. / KI-generierte Zusammenfassung zu Bildungszwecken – ersetzt keine medizinische, rechtliche oder finanzielle Fachberatung.